ALIGNWORLD

实验

01

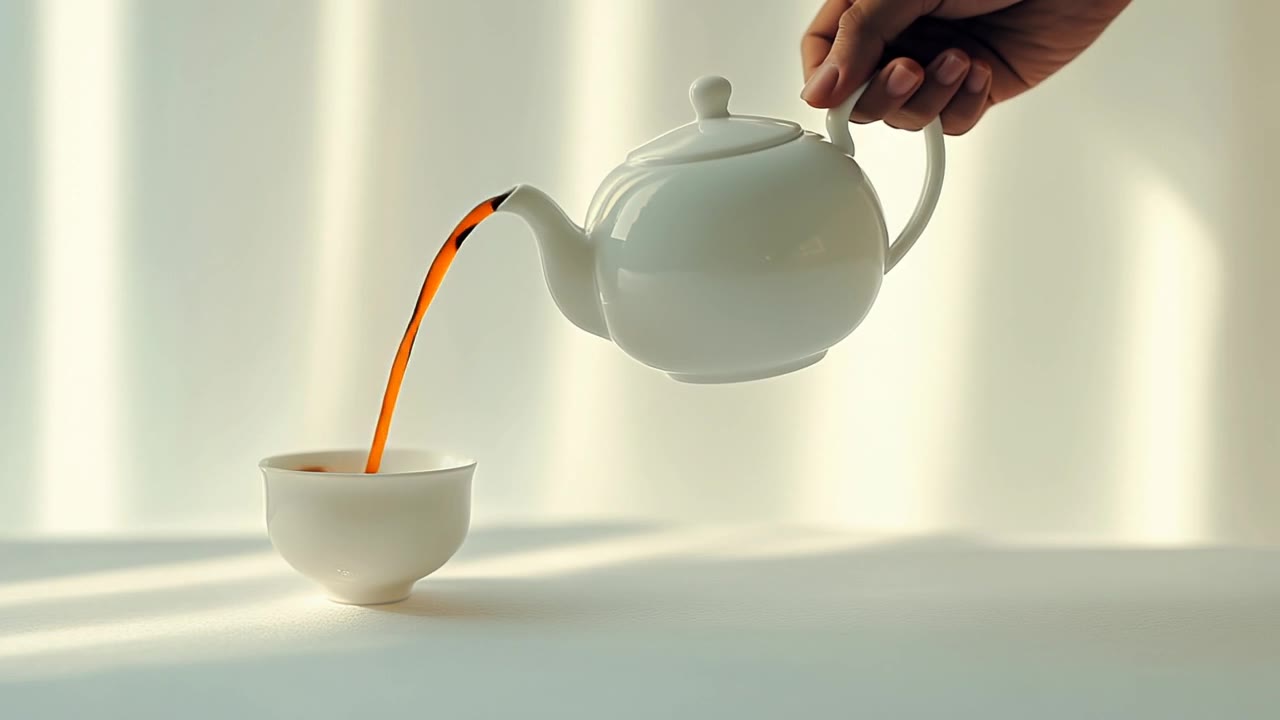
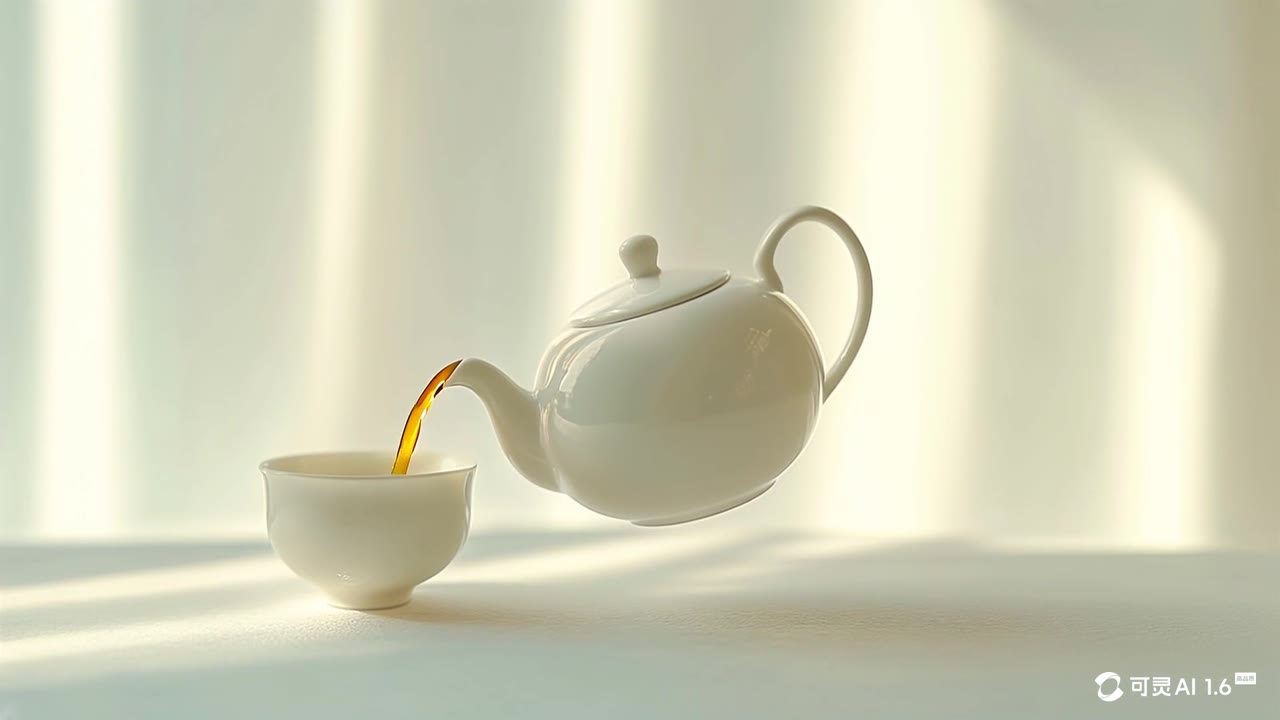
2025一句话生成画面把一句描述交给视频模型,由模型直接画出每一帧。足够写实,但要靠抽卡,细节改不了。

同一句提示词 · 2 个模型

「水壶往杯子里倒茶」

水壶往杯子里倒茶视频封面

Runway Gen-45 秒

水壶往杯子里倒茶视频封面

可灵 1.65.1 秒

画面都很像样,物理还不太懂:Gen-4 让一只手伸进来提壶,可灵 1.6 里的茶壶自己飘起来倒茶。

这不是同一种能力在变强,而是做法变了:从让模型直接画出每个像素,到让模型写出能生成画面的代码。

02

2026写代码做动效让 Claude 写 HTML / CSS / Shader,浏览器渲染后录屏。不追求写实,但每一帧都可控、可改、可重来。
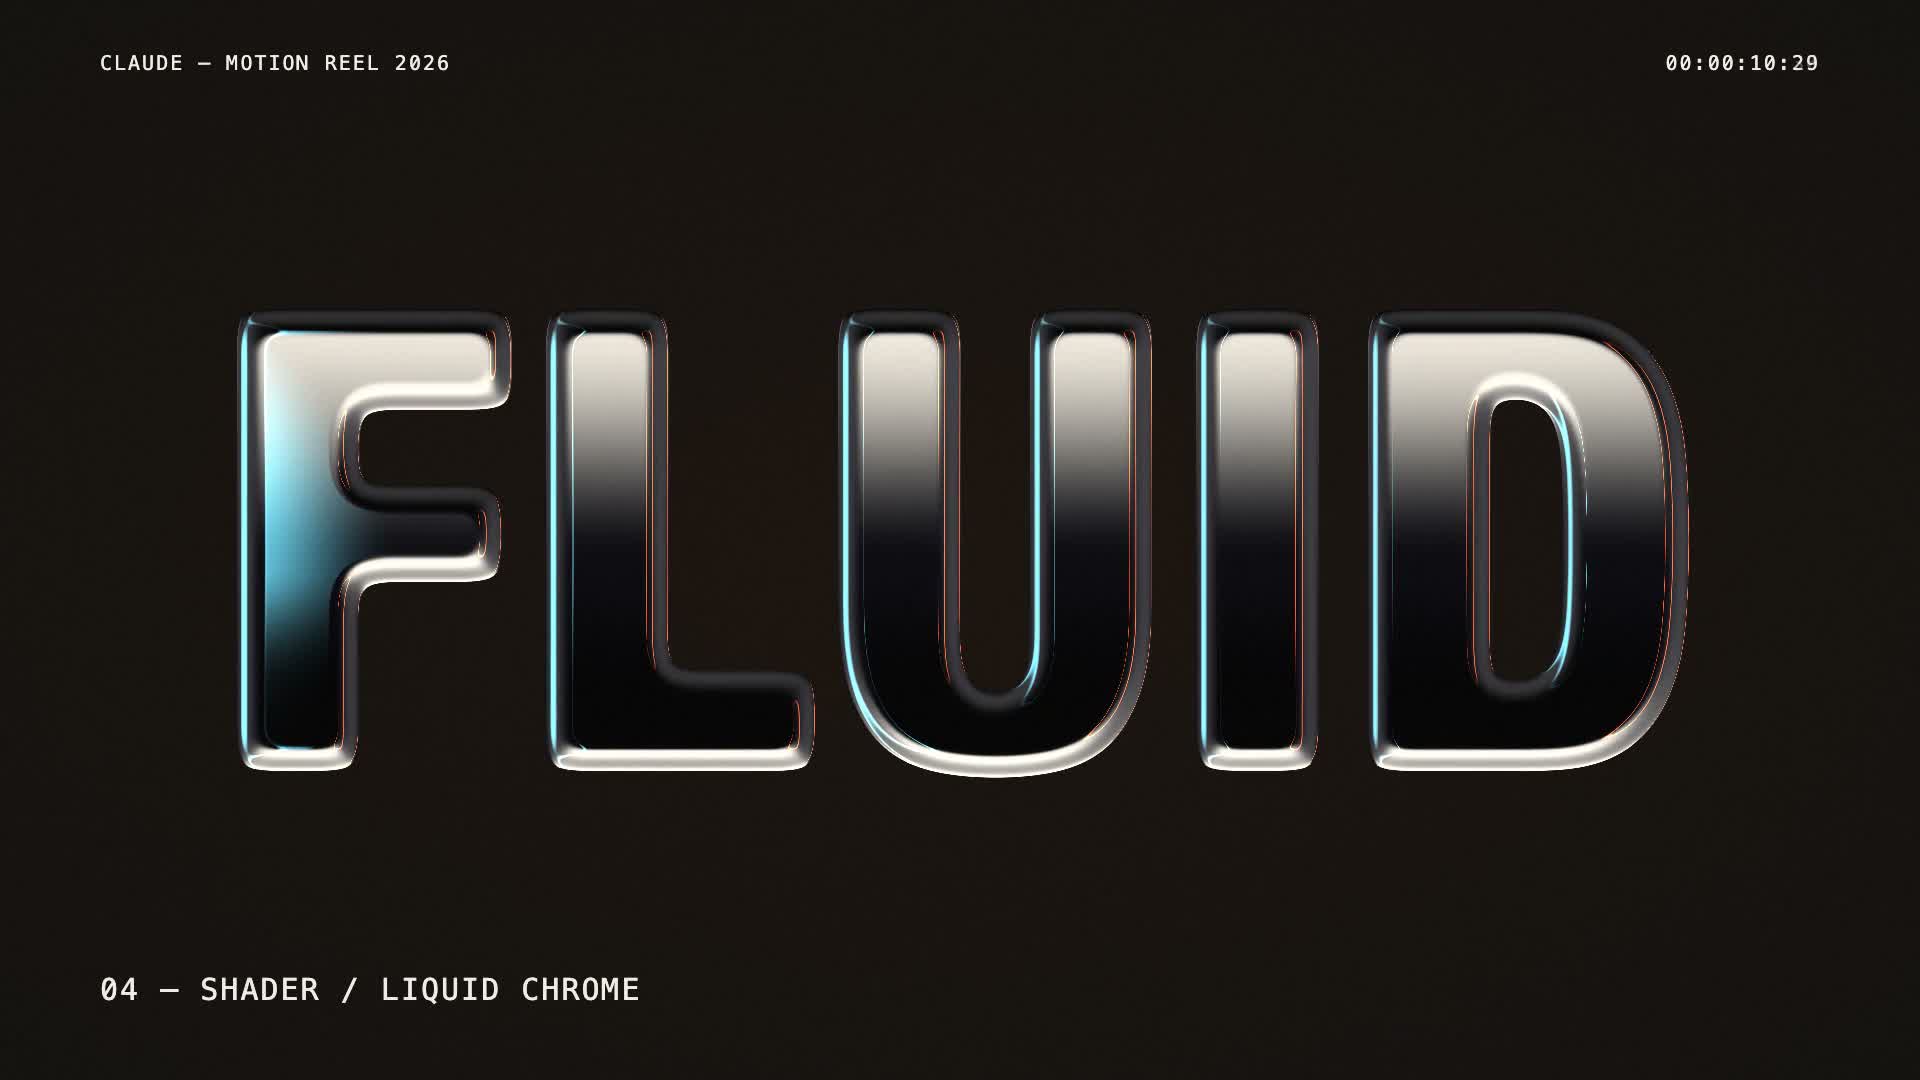
AI 动效短片视频封面

AI 动效短片

Claude Opus 5.5 · Steve · 15 秒

这也是下面这些知识演示的做法:同样是让模型写网页,只是从做动效,变成把一个概念拆开讲清楚。看知识演示 ↓

知识演示

从模型怎么读懂文字,到怎么说话、查资料、组织知识,再到动手办事,一级一级往上走。每个演示都能播放、暂停、逐步推进。

  1. Embedding 与语义空间

    模型怎么知道“小狗”和“宠物”说的是一回事?

    1. 文本
    2. 向量
    3. 语义空间
    4. 相似度
    5. 语义搜索

    5 个阶段 · 可切换查询

  2. 大语言模型的输出机制

    模型是怎么一个词一个词把话说出来的?

    1. 分词与嵌入
    2. 注意力
    3. 概率
    4. 采样
    5. 输出

    5 个阶段 · 可调温度与速度

  3. RAG:检索增强生成

    模型没学过的资料,怎么让它答对?

    1. 直接提问
    2. 切块与向量化
    3. 向量检索
    4. 重排
    5. 带资料回答

    5 个阶段 · 可调检索数量与重排

  4. 从数据到本体

    一张交易表,怎么变成一套概念体系?

    1. 原始数据
    2. 实体消歧
    3. 类型归纳
    4. 关系抽取
    5. 抽象本体

    5 个阶段 · 逐步推进 · 本体 · 上篇

  5. 知识图谱与本体

    图谱记事实,本体定规则,两者怎么配合?

    1. 知识图谱
    2. 本体
    3. 实例化
    4. 约束校验
    5. 推理

    5 个阶段 · 逐步推进 · 本体 · 下篇

  6. Agent:从回答到办事

    模型怎么从回答问题,变成动手把事办完?

    1. 目标
    2. 查订单
    3. 查政策
    4. 问用户
    5. 确认并执行

    5 个阶段 · 关键操作需确认

从 2023 年到现在,我对 AI 的看法一直在变。每个点是一篇文章,放在事件发生的时间上;有了新的判断,就接在那条线的末尾。

  1. 01「赢」的定义
  2. 02开放是一种策略
  3. 03规则、资本与权力
  4. 04模型长在哪
  5. 05从对话到行动
  6. 06人、作品与陪伴
  7. 07身体与硬件

持续更新

你好,我是 Steve。

我关注 AI、产品和个人表达,也喜欢把冒出来的想法,做成可以亲手试一试的东西。